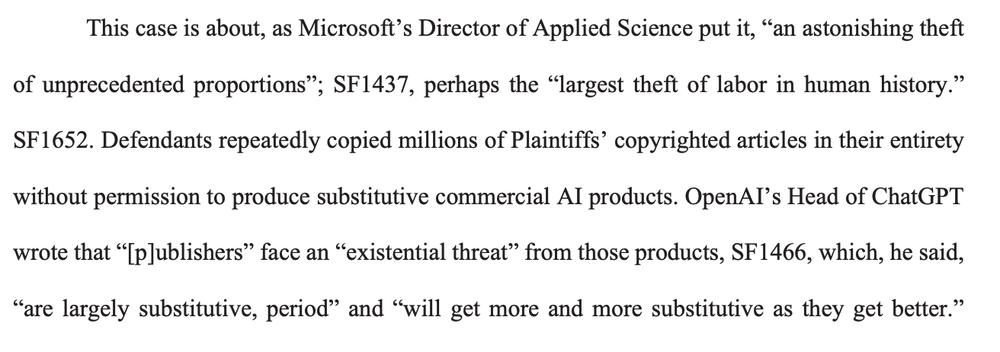
В рассекреченных судебных документах по иску New York Times к OpenAI руководители Microsoft и OpenAI признали, что большие языковые модели построены на использовании чужого контента без компенсации авторам. Внутренний документ Microsoft называет это «поразительным воровством беспрецедентных масштабов» и «крупнейшей кражей труда в истории человечества».
По данным документа, продукты генеративного ИИ создают «петлю погибели»: они копируют контент, а затем перетягивают на себя трафик, разрушая бизнес-модели его создателей. Руководители Microsoft, включая генерального директора Сатью Наделлу, подтвердили под присягой, что после использования материалов New York Times и других изданий количество переходов на их сайты упало более чем на 90%.
Документы показали также, что OpenAI создала способ обхода платного доступа к контенту New York Times. Директор компании по вопросам политики Джек Кларк заявил, что OpenAI создаёт системы, замещающие труд людей, формирующих культуру общества.
Юристы обеих компаний настаивают, что обучение моделей подпадает под принцип добросовестного использования контента. Судебный процесс продолжается.