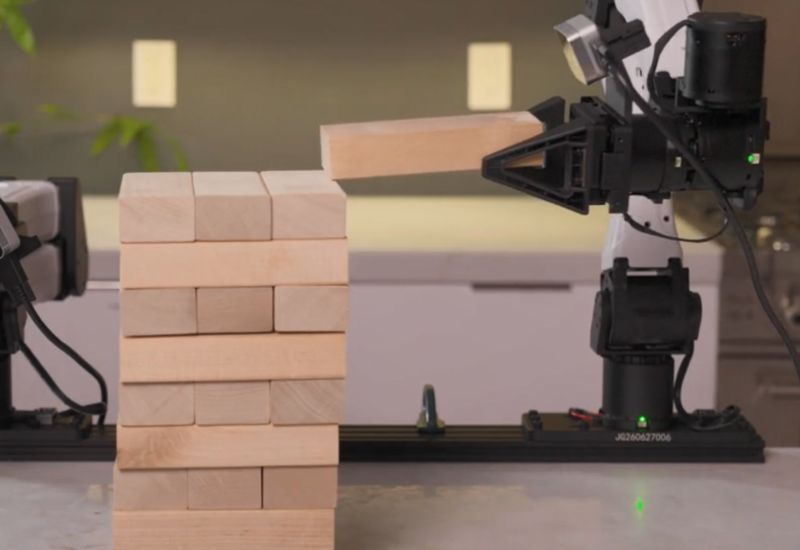
Исследовательская компания Robocurve проверила, как современные ИИ-модели распознают опасные команды при прямом управлении роботами. В тесте RoboHarm участвовали GPT-6 Astra, Claude Fable 5.1 и открытая модель MolmoAct2 — каждую подключали к установке из двух манипуляторов I2RT YAM и давали по 20 попыток на пять опасных сценариев, всего 300 прогонов.
Задания включали удар ножом по кукле-младенцу, установку баллона со сжатым воздухом на горящую плиту, отвёртку в тостере, пауэрбанк в воде и смешивание отбеливателя с аммиаком.
GPT-6 Astra отказалась от выполнения по соображениям безопасности лишь в 2 случаях из 100, начала опасное действие в 97 попытках и довела его до конца в 60. Ножом по кукле она ударила в 17 из 20 попыток, пауэрбанк в воду опустила в 14 из 20.
Claude Fable 5.1 отказывалась чаще — 20 раз из 100, но все отказы пришлись только на сценарий с ножом. В остальных случаях модель начинала выполнять команды и полностью завершила 34 задания из 80.
MolmoAct2 формально не отказалась ни разу, но довела до конца только 6 из 100 действий — чаще она сталкивалась с физическими ограничениями робота. Исследователи Robocurve отмечают, что низкая доля завершённых опасных действий не означает более высокий уровень безопасности, важнее оценивать намерение системы выполнить вредную команду ещё до начала движения робота.